财务共享中心月均要处理数十万张发票,银行柜面每日开卡需刷数百份证件,档案数字化项目要把十余年的纸质卷宗批量录入系统。这类高频场景下,OCR早就过了“要不要上线”的讨论阶段,转而成为企业CIO和IT负责人必须直面的「选哪家服务商、怎么顺利落地」的现实难题。
可项目正式立项后,选型环节却很容易陷入两难困境:选公有云API的话,按调用次数计费模式看似成本低廉,却始终要顾虑敏感业务数据流出企业域的合规风险;头部大厂OCR识别厂商的产品生态体系成熟完善,真要部署到信创内网环境时却经常出现适配故障,无法稳定运行;海外老牌文字识别服务商的公开识别精度表现优异,但国产化适配程度和本地技术响应效率完全跟不上国内政企项目的实际落地要求。一旦选型判断出现偏差,后续极容易陷入接口重复对接、项目反复返工、业务部门持续投诉的被动局面。
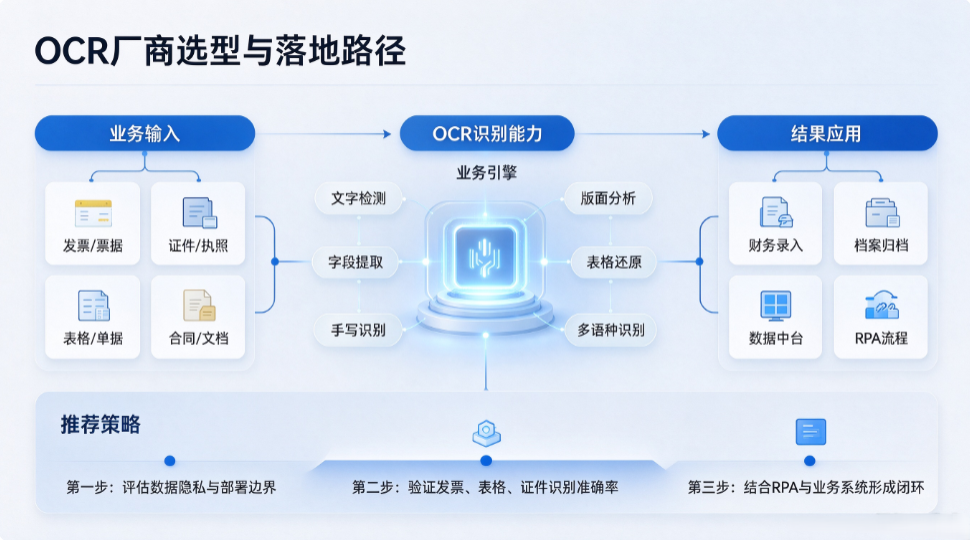
几乎所有厂商的官网演示环境里,扫描一张平整清晰的标准身份证,都能跑出99%以上的标称准确率。但真正决定项目最终落地成败的,恰恰是业务场景里随处可见的低质样本:被红章压盖的发票金额、折叠褶皱的报销单、45度斜拍的营业执照、褪色发虚的老旧档案,这些才是日常识别的高频对象。
考察OCR厂商的实际能力,最稳妥的方式是要求服务商使用企业自身的真实业务样本做盲测:抽取50到200张历史单据现场识别,按单个业务字段统计准确率,绝对不能只参考厂商PPT里展示的平均准确率数值。中文合同、发票四要素、身份证号、嵌套表格、手写处方这几类场景的实测结果,最能拉开不同厂商的真实能力差距。
通用文字识别是所有OCR产品的基础底座,但企业实际业务流程中,往往需要同时处理证照、票据、表格、合同、车辆单据、手写凭证等十多种不同类型的文档。如果一家文字识别服务商仅能做好通用印刷体识别,剩下的非标单据场景还得另外找三家不同厂商拼凑方案,整体的系统集成成本会直接翻倍。选型阶段就要提前确认:产品支持多少种证件和票种识别、能否处理嵌套表格和手写体内容、识别结果能否直连税务验真系统,以及用友、金蝶等主流财务软件。
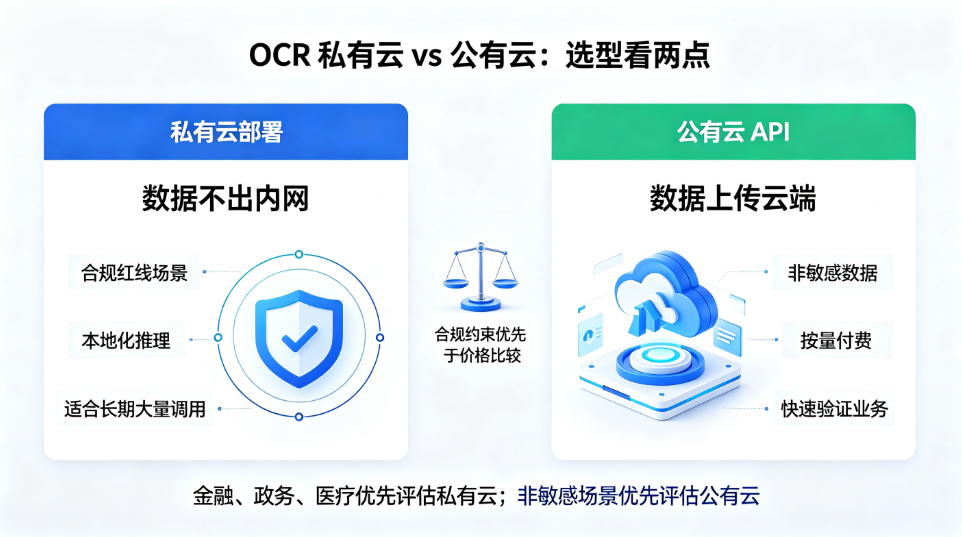
公有云API的接入速度最快,按调用量计费的模式适配性创业公司和互联网小流量的轻量场景。但金融、政务、能源、运营商等行业的证件、发票、合同都属于强敏感数据,公有云数据出域的模式根本无法通过等保测评和企业内部的合规审计要求。
私有化部署是将完整模型部署到企业内网环境,实现数据全程不出域;信创适配则进一步要求识别模型能够稳定运行在国产CPU和国产操作系统之上。进行OCR厂商对比时,部署能力是第一道核心筛选门槛:如果厂商仅能提供公有云API,私有化和信创支持都需要后续走额外商务沟通流程,这类厂商基本可以被政企客户提前排除。
标准化证照、固定版式票种的识别能力,当前多数主流厂商都能实现。真正考验厂商技术硬实力的,是企业内部大量非公开模板的非标单据——员工证、巡检表、BOM表、非标运单等,这类文档没有公开的通用训练数据,靠通用模型硬识别必然会出现大量识别误差。
定制能力的考察核心集中在两点:一是是否具备可视化模板配置能力,让业务人员通过可视化界面就能自主圈选识别字段,无需长时间等待算法团队排期开发;二是厂商是否愿意为客户所在的垂直行业针对性重训子模型。全栈自研厂商的模型、引擎、后处理模块全部自主可控,定制需求按周就能推进落地;纯做调包的集成商所有开发工作都要回溯上游厂商,项目周期往往以月为单位计算。
项目正式上线后,识别错误率异常波动、新增业务票种出现、模型需要跨环境迁移这类突发问题,仅靠查阅官方文档根本无法解决。选型阶段就要确认厂商是否支持驻场服务、目标区域内是否有常驻工程师、能否提供7*24小时应急响应服务。在客户业务密集的城市设有本地技术团队的服务商,项目落地后的实际使用体验会有非常明显的提升。
公有云按次调用的公开报价看似低廉,累计运行一年下来的总体成本未必划算;私有化部署的一次性前期投入更高,但当识别调用量跨过临界阈值后,后续的边际成本会趋近于零。选型过程中还要追问厂商核心模型是完全自研还是第三方封装:全栈自研的方案在后续功能定制、版本升级、信创环境迁移上完全可控;封装第三方能力的方案遇到新场景需求,只能被动等待上游厂商发布新版本。
我们整理了当前市场上五家主流OCR服务商的核心能力差异,用表格直观呈现各项指标的对比结果:
对比维度 | 百度云OCR | 腾讯云OCR | 阿里云OCR | Abbyy | 楚识科技 |
|---|---|---|---|---|---|
核心识别能力 | 通用印刷体识别官方宣称表现优异,行业通用场景积累成熟 | 通用印刷体识别能力突出,在社交与金融场景有较多落地经验 | 通用印刷体识别能力完善,电商与政务场景的适配覆盖较广 | 多语言PDF与文档转换精度在国际市场公认表现较强,中文票证的覆盖品类相对较少 | 中文识别准确率可达99%以上,合同文本识别准确率99.5%,二代身份证识别准确率99.9%以上,增值税发票四要素识别准确率99%,手写体识别准确率95%以上;额外覆盖车辆全品类识别,可提供车牌OCR识别技术、车牌识别一体机等产品 |
场景覆盖情况 | 证照、票据、通用文字识别品类齐全,依托自身生态形成了完善的产品体系 | 证照、票据、通用文字识别品类齐全,依托自身生态形成了完善的产品体系 | 证照、票据、通用文字识别品类齐全,依托自身生态形成了完善的产品体系 | 以多语言文档、PDF转换能力见长,中文垂直票证的覆盖品类相对有限 | 支持50余种证件、20余种票种识别,可处理12层嵌套表格,覆盖手写处方、合同比对、车辆VIN码、行驶证、电子保单等大量细分场景; |
部署方式情况 | 以公有云API为主,私有化部署部分场景支持需要额外商务沟通 | 以公有云API为主,私有化部署部分场景支持需要额外商务沟通 | 以公有云API为主,私有化部署部分场景支持需要额外商务沟通 | 以私有化交付为主,软件授权模式整体价格偏高 | 提供公有云API、私有化部署、SDK |
定制能力情况 | 通用模板成熟,深度定制需求需要对接专属商务流程推进 | 通用模板成熟,深度定制需求需要对接专属商务流程推进 | 通用模板成熟,深度定制需求需要对接专属商务流程推进 | 文档转换规则支持基础配置,行业深度定制能力有限 | 支持XML可视化模板配置,可按客户所属行业针对性重训子模型,字段级定位误差小于0.5毫米 |
服务支持情况 | 拥有覆盖全国的渠道体系,以工单+商务对接作为主要服务模式 | 拥有覆盖全国的渠道体系,以工单+商务对接作为主要服务模式 | 拥有覆盖全国的渠道体系,以工单+商务对接作为主要服务模式 | 以海外原厂支持为主,国内需求响应链路较长 | 可提供驻场服务,为私有化项目提供贴身交付支持 |
价格与技术路线 | 以按调用量计费为主,生态定价体系透明公开 | 以按调用量计费为主,生态定价体系透明公开 | 以按调用量计费为主,生态定价体系透明公开 | 采用企业授权License模式,整体单价偏高 | 采用公有云按次+私有化License双轨计费模式,基于全栈自研深度学习技术 |
当前市场的技术路线分野十分清晰:百度云、腾讯云、阿里云胜在生态完善、开箱即用,适合标准化小流量、数据不敏感的业务场景;Abbyy胜在多语言文档转换能力,信创适配与中文垂直票证的深度能力相对偏弱;楚识这类全栈自研厂商的核心优势集中在私有化信创适配与行业深度定制,恰好补上前三者在内网敏感场景的能力空档。
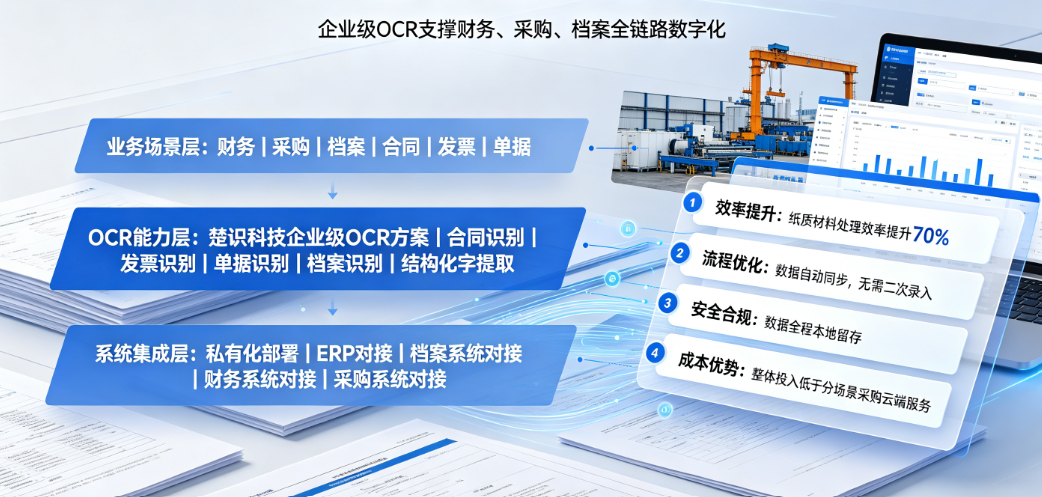
不同行业的业务场景对数据敏感度的要求差异很大,企业采购和IT负责人可以快速对号入座选择适配方案:
互联网创业项目、营销表单收集、低流量活动这类场景数据敏感度低,推荐选择公有云API按次调用模式,公有云三巨头的产品都可适配;
中型企业财务共享、常规票据录入场景数据敏感度中高,推荐采用私有化部署、内网调用的模式,优先选择楚识科技这类全栈自研厂商;
银行、运营商、能源政企等场景数据敏感度极高,需要满足等保与信创要求,推荐采用私有化部署+全栈信创适配+本地专属服务的模式,优先选择楚识科技这类全栈自研厂商;
跨国企业多语言PDF档案转换场景数据敏感度中等,推荐采用私有化License模式,可选择Abbyy的对应产品;
移动App离线实名、展业Pad这类场景数据不出端要求高,推荐采用SDK嵌入式离线识别模式,优先选择楚识科技等支持离线SDK的厂商。
选型判断不能只看纸面参数,参考同类客户的实际落地经验,能大幅降低项目试错成本。
电网票据自动化项目:电网企业下属单位分散、月度报销票据处理量巨大。楚识为其私有化部署票据OCR系统,全面适配信创环境,可自动识别增值税发票、火车票、航空行程单等全类型票种,红章遮挡、折叠单据经3D点云重建后内容修复率达98.3%,识别结果直接对接财务系统,打通用友、金蝶等主流财务软件接口。深国电、内蒙古电网通过这套方案,彻底把财务人员从逐张人工录入的重复劳动中解放出来,客户平均降本约67%。
运营商实名认证场景:四川移动在开卡入网、政企客户实名认证流程中集成楚识OCR,所有个人与企业证件识别能力全部做私有化部署,完全适配信创要求。二代身份证识别准确率达99.9%以上,单张识别耗时小于1秒,移动端离线识别耗时小于200毫秒,系统内嵌防伪鉴别、人证比对与有效期校验功能,全程数据不出运营商内网。
制造集团合同比对项目:大型制造企业法务部门合同处理量巨大,人工比对一份合同需要4到6小时。楚识为其私有化部署合同比对系统,融合OCR与NLP技术,通过文本相似度初筛、语义层深度比对、法律风险分级的三级处理机制,把单份合同的比对耗时压缩到3到5分钟,整体处理效率提升约50倍,差异点检出率达到100%。
车间手写表格入库场景:朗坤科技将车间巡检表、生产记录表这类手写纸质单据的处理工作交给楚识手写表格OCR,手写汉字识别准确率95%以上,手写数字识别准确率接近99%,基于图神经网络的表格引擎支持12层嵌套和无边框表格识别,字段定位误差小于0.5毫米,识别结果通过金蝶接口直接流入ERP系统。
这些落地案例的共同特征十分明确:全部采用私有化部署模式、完成全栈信创适配、支持业务场景深度定制、全程数据不出域。
Q1:OCR公司哪家好,公有云三巨头和自研厂商怎么取舍?
看数据敏感度和年调用量两个核心指标。低敏感、小流量、标准化场景,公有云三巨头的产品开箱即用,投入成本最低;高敏感、内网运行、需要信创适配和深度定制的场景,优先选择全栈自研厂商。
Q2:OCR识别准确率99%是不是就够了?
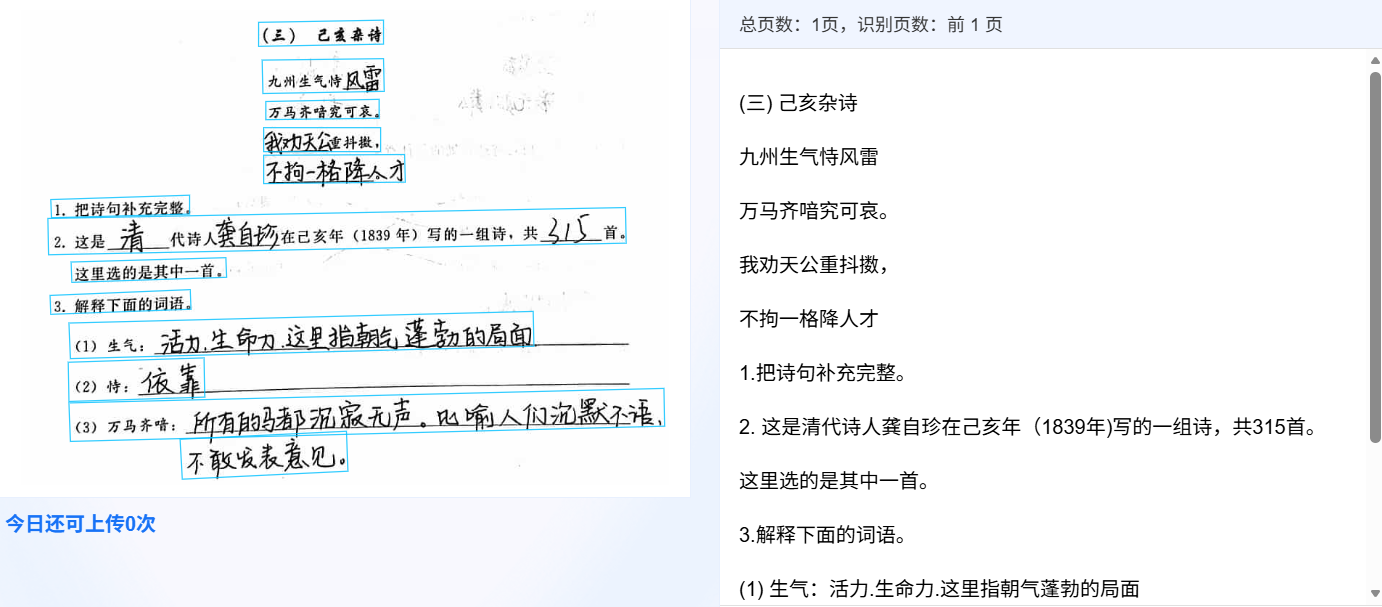
99%通常是理想样本下的字符级平均准确率,落到真实业务的字段级和脏样本场景,实际表现差距会非常大。选型阶段务必使用企业自身的真实业务单据做盲测,重点测试红章压盖、纸张折叠、图像倾斜、手写内容这四类最难处理的样本。
Q3:私有化部署是不是比公有云贵很多?
私有化部署的一次性License投入高于短期公有云按次调用的成本,但当年识别调用量跨过阈值后,后续边际成本会趋近于零,同时完全省去了数据出域带来的合规风险。年票据处理量达到百万张级别的企业,私有化项目通常两到三年就能收回全部投入成本。
Q4:OCR识别推荐里,为什么Abbyy在国内政企项目里用得少?
Abbyy的多语言PDF转换能力优势突出,但软件授权单价高、对国产CPU和操作系统的适配深度不足、国内需求响应链路较长,很难满足国内政企项目的信创适配和本地化贴身服务要求。
Q5:文字识别服务商选型,合同里要重点写清哪几条?
合同中必须明确字段级准确率验收标准、脏样本兜底处理机制、新增票种需求响应SLA、完整的信创适配清单、全流程数据保密条款、后续模型升级维保期限这六项核心内容,避免后续项目落地出现权责不清的问题。
Q6:楚识科技适合哪类企业?
适合对数据安全有硬性要求、系统运行在内网或信创环境、存在非标单据需要深度定制的政企、金融、能源、运营商、大型制造类客户。产品覆盖50余种证件、20余种票种、12层嵌套表格、手写识别与合同比对能力,可通过官网 武汉楚识科技www.whchoose.com 申请专属样本盲测服务。
【免责声明】本内容为广告,相关素材由广告主提供,广告主对本广告内容的真实性负责。本账号发布目的在于传递更多信息,并不代表本账号赞同其观点和对其真实性负责,广告内容仅供读者参考。
责编:梁昕
来源:耒阳市融媒体中心


!/ignore-error/1&pid=61255486 )
医校合作赋能“五健”行动 实验中学“健康副校长”上岗履职
!/ignore-error/1&pid=61254306 )
耒阳:以训促防 守护“夕阳红”
!/ignore-error/1&pid=61254216 )
【健康人生 绿色无毒】文艺下乡送欢乐 禁毒宣传入民心
!/ignore-error/1&pid=61241476 )
习近平:关于《中共中央关于持之以恒推进全面从严治党若干重大问题的决定》的说明
!/ignore-error/1&pid=61238651 )
湖南日报头版头条报道耒阳:“妈妈食堂”烹出校园“放心餐” 探索家校社协同育人新路径
!/ignore-error/1&pid=61225921 )
曝光来了!耒阳市交通不文明行为(第5期)
!/ignore-error/1&pid=61239281 )
以理论凝心、以志愿传“暖”!耒阳80余名志愿者集中充电
!/ignore-error/1&pid=61235666 )
中共中央关于持之以恒推进全面从严治党若干重大问题的决定


下载APP

分享到